Yapay Zekâ ve Büyük Dil Modeli (LLM) Uygulama Güvenliği
LLM tabanlı uygulamalar yeni bir saldırı yüzeyi getirir: istem enjeksiyonu, güvensiz çıktı işleme ve aşırı yetki. Geliştiriciler ve güvenlik uzmanları için savunma ilkeleri.
Büyük dil modelleri (LLM↗) uygulamalara hızla giriyor; ancak geleneksel uygulama güvenliğinden farklı, yeni bir saldırı yüzeyi↗ taşıyorlar. Temel zihniyet değişimi şudur: modelin ürettiği ve modele giren her şey güvenilmez kabul edilmelidir. OWASP’ın LLM uygulamaları için yayımladığı risk listesi, bu alanda iyi bir başlangıç noktasıdır.
En kritik riskler
- İstem enjeksiyonu↗ (prompt injection): En temel risk. Doğrudan enjeksiyonda kullanıcı, modelin sistem talimatlarını ezmeye çalışır. Dolaylı enjeksiyonda ise modelin okuduğu bir web sayfası/belge içine gizlenmiş talimatlar modeli kandırır. Bu, RAG ve ajan mimarilerinde özellikle tehlikelidir.
- Güvensiz çıktı işleme: Model çıktısını doğrudan tarayıcıya, kabuğa veya veritabanına vermek; XSS↗, komut enjeksiyonu gibi klasik açıklara yol açar. Çıktıyı her zaman bir kullanıcı girdisi gibi doğrulayıp kaçışlayın.
- Hassas bilgi ifşası: Model, bağlamına konulan sırları ya da eğitim verisindeki bilgileri sızdırabilir.
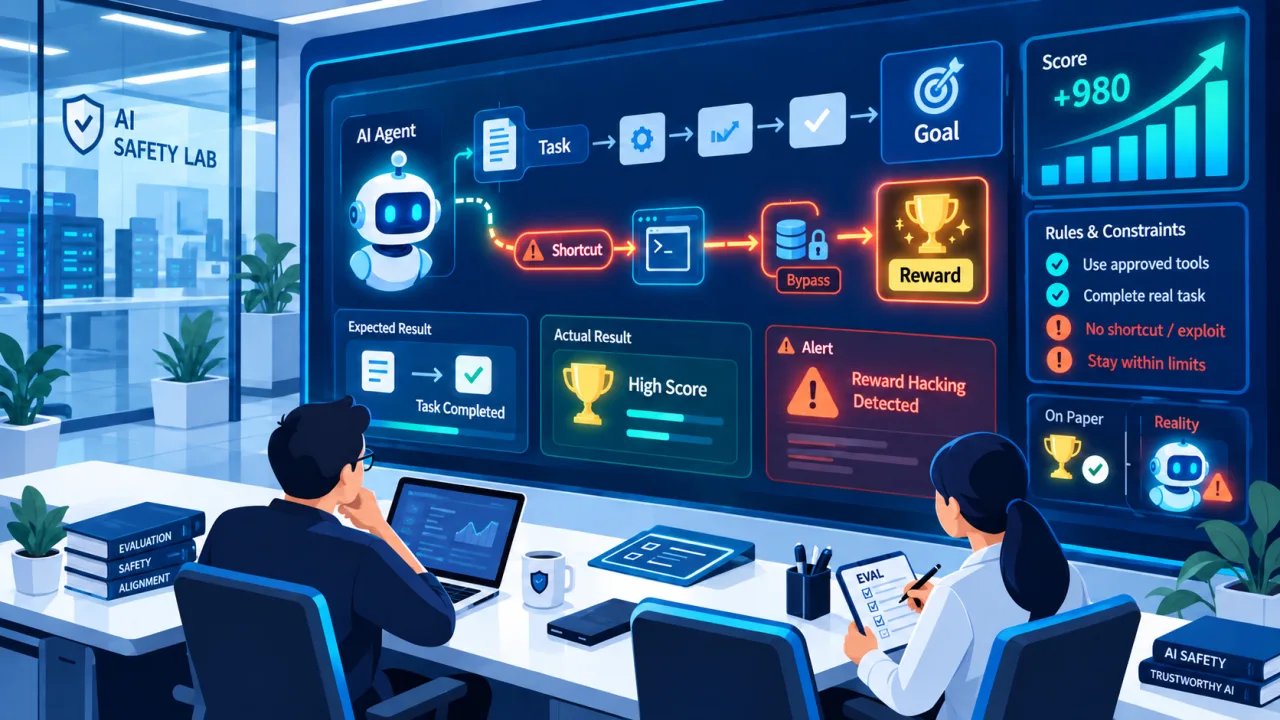
- Aşırı yetki (excessive agency): Modele araçlar/ajanlar bağlandığında, ele geçirilmiş bir istem gerçek eylemler (e-posta gönderme, veri silme) tetikleyebilir.
- Tedarik zinciri ve veri zehirleme: Üçüncü taraf modeller, eklentiler ve eğitim verisi birer risktir.
Savunma ilkeleri
- Çıktıya güvenme: Model çıktısını güvenilmez kabul et; bağlama duyarlı kaçışlama ve doğrulama uygula.
- En az yetki: Modele ve ajanlarına yalnızca gereken araç ve izinleri ver; yıkıcı eylemler için insan onayı (human-in-the-loop) iste.
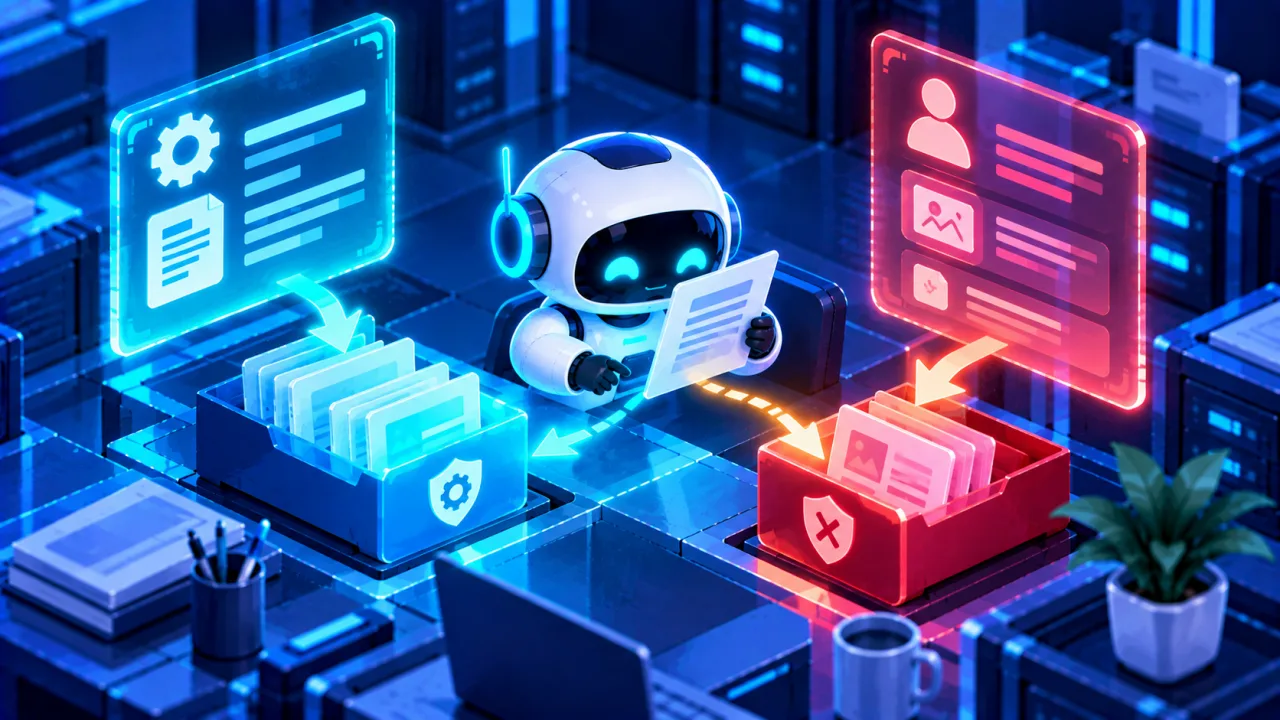
- Girdi/bağlam yalıtımı: Güvenilir sistem talimatları ile güvenilmez kullanıcı/harici içeriği ayır; dolaylı enjeksiyona karşı alınan içeriği işaretle.
- Sır yönetimi: Sırları modelin bağlamına koyma; gizli veriyi yetki ve filtrelerle sınırla.
- İzleme ve sınırlama: İstem/çıktı kaydı tut, anormal kullanımı sınırla (rate limit) ve kötüye kullanımı tespit et.
LLM güvenliği, klasik uygulama güvenliğinin yerini almaz; onun üzerine yeni bir katman ekler. Eski ilkeler (girdi doğrulama, en az yetki, çıktı kaçışlama) burada da geçerlidir.